Loading a pretrained LLM
我们花了很多时间准备用于指令微调的数据集,这是监督微调过程中的一个关键方面 。许多其他方面与预训练相同,使我们能够重用早期章节中的大量代码。
在开始指令微调之前,我们必须首先加载一个我们想要微调的预训练GPT模型(见 图7.15),这是我们之前进行过的过程。
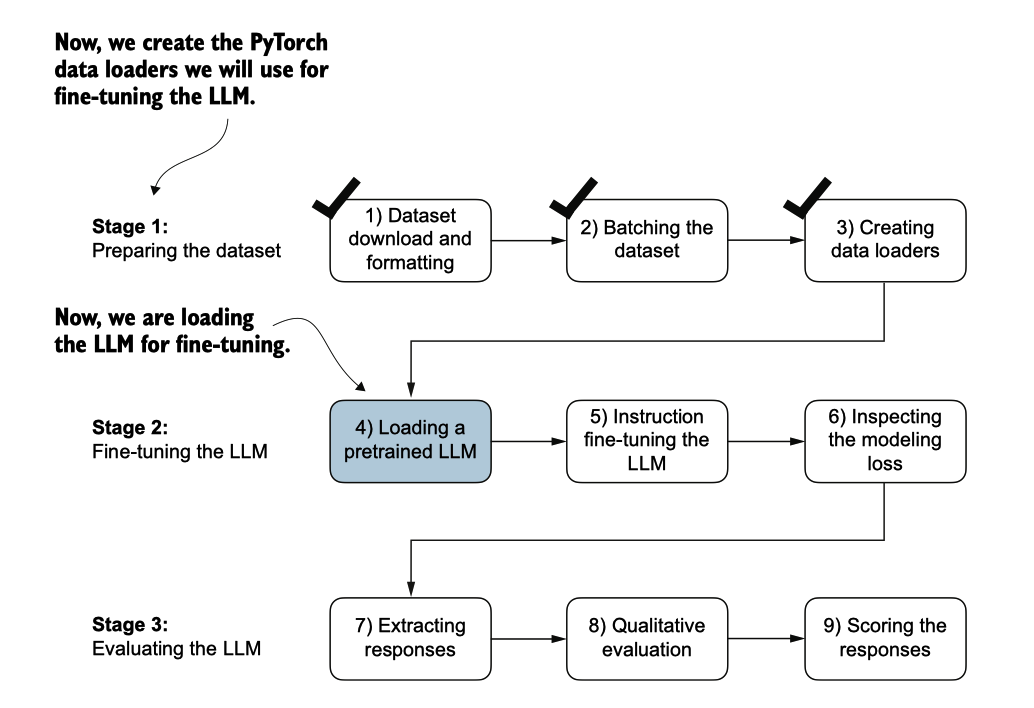
图7.15 三阶段的指令微调大型语言模型(LLM)流程。
通过指令微调获得令人满意的结果。具体来说,较小的模型缺乏学习和保留高质量指 令遵循任务所需的复杂模式和细微行为的必要能力。
加载我们预训练的模型需要与我们预训练数据和为了分类进行微调时相同的代码,只是我们现在指定“gpt2-medium (355M)”而不是“gpt2-sm all (124M)”。
现在,让我们花一点时间评估预训练的LLM在验证任务之一上的表现,通过将其输出 与预期响应进行比较。这将为我们提供一个基线,了解模型在未经微调的情况下,在 指令跟随任务上的表现如何,并帮助我们在后续评估微调的效果。我们将使用验证集 中的第一个示例进行此次评估.
接下来,我们使用在预训练模型时使用的相同生成函数来生成模型的响应
generate函数返回组合的输入和输出文本。这种行为之前是便利的,因为预训练的LLM主 要被设计为文本补全模型,在这些模型中,输入和输出被连接在一起以创建连贯且易读的文本。然而,在评估模型在特定任务上的表现时,我们通常希望专注于模型生成的响应。
为了隔离模型的响应文本,我们需要从生成文本的开始减去输入指令的长度
这段代码从生成的文本的开头移除输入文本,只留下模型生成的响应。
该输出表明,预训练模型尚未能够正确遵循给定的指令。虽然它确实创建了一个响应 部分,但它只是重复了原始输入句子和部分指令,未能如请求所示地将主动语态句子 转换为被动语态。
因此,让我们现在实施微调过程,以提高模型理解和适当地回应此类请求的能力。
Fine-tuning the LLM on instruction data
是时候对LLM进行微调以便执行指令(图7.16)。
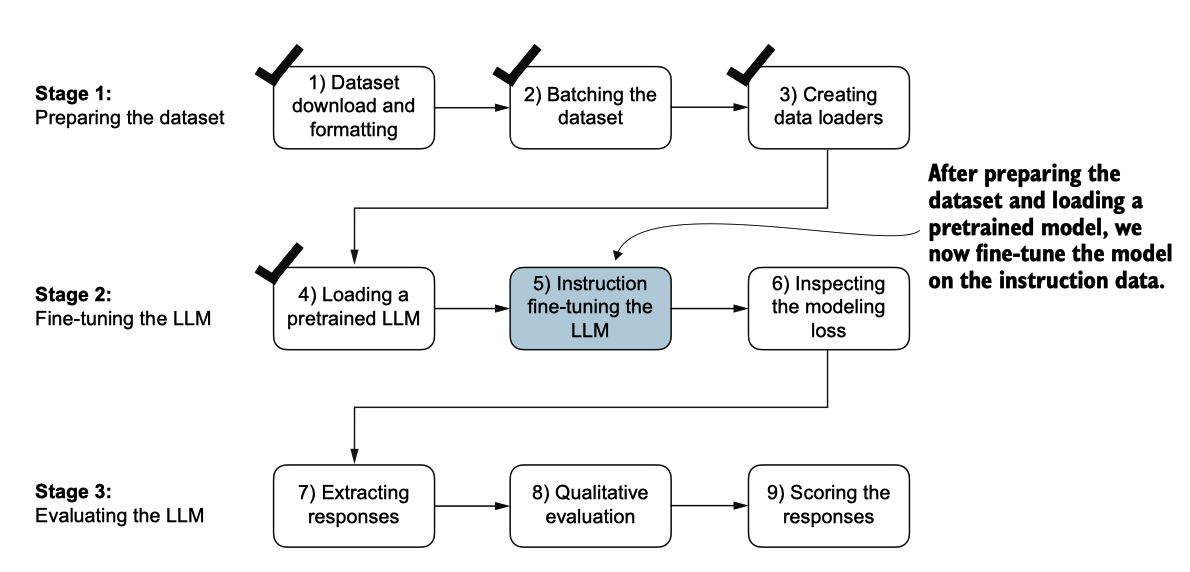
图7.16 对LLM进行指令微调的三阶段过程。在第5步中,我们在之前加载的预训练模型上,在我们早先准备的指令 数据集上进行训练。
我们将采用上述加载的预训练模型,并使用本章早些时候准备的指令数据集进一步训练它。当我们在开头实现指令数据集处理时,所有的繁重工作已经完成。
对于微调过程本身,我们可以重用之前实现的损失计算和训练函数:
from previous_chapters import (
    calc_loss_loader,
    train_model_simple
)
在我们开始训练之前,让我们计算训练集和验证集的初始损失
准备好模型和数据加载器后,我们现在可以开始训练模型。下面的代码设置了训练过程,包括初始化优化器、设置轮次数量以及定义评估频率和评估生成的 LLM 响应的初始上下文,评估基于我们在之前的第一个验证集指令 (val_data[0]) 。
训练输出表明模型正在有效学习,从两个时期中持续降低的训练和验证损失值可以看 出这一点。这个结果表明模型正在逐渐提高理解和遵循提供的指令的能力。(由于模 型在这两个时期内表现出了有效的学习,延长训练到第三个或更多时期并不是必要的 ,甚至可能适得其反,因为这可能导致过拟合增加。)
此外,在每个时期结束时生成的响应使我们能够检查模型在验证集示例中正确执行 给定任务的进展。在这种情况下,模型成功地将主动句"The chef cooks the meal every day."转换 为其被动语态对应句:"The meal is cooked every day by the chef."
我们稍后将更详细地回顾和评估模型的响应质量。现在,让我们检查训练和验证损 失曲线,以更深入地了解模型的学习过程。为此,我们使用与预训练时相同的plot_losses 函数:
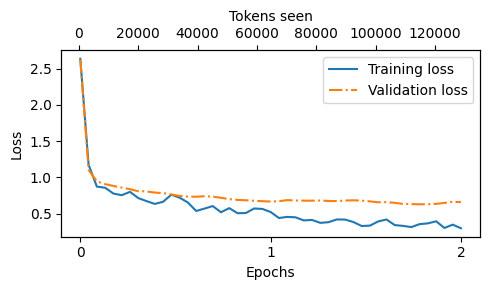
图 7.17 两个周期内训练和验证损失的趋势。实线代表训练损失 ,在稳定之前显示出急剧下降,而虚线代表验证损失,遵循类 似的模式。
从图7.17所示的损失图中,我们可以看到模型在训练集和验证集上的表现随着训练过 程的推进显著改善。初始阶段损失的快速下降表明模型迅速从数据中学习到有意义的 模式和表示。然后,当训练进入第二个时代时,损失继续减少,但速度较慢。
虽然图7.17中的损失图表明模型正在有效训练,但最关键的方面是其在响应质量和准 确性方面的表现。因此,我们接下来提取响应并将其存储在一种可以评估和量化响应 质量的格式中。
Extracting and saving responses
在针对指令数据集的训练部分微调了LLM之后,我们现在准备好在保留的测试集上评 估其性能。首先,我们提取测试数据集中每个输入生成的模型响应,并将其收集进行 人工分析,然后我们评估LLM以量化响应的质量,如图7.18所示。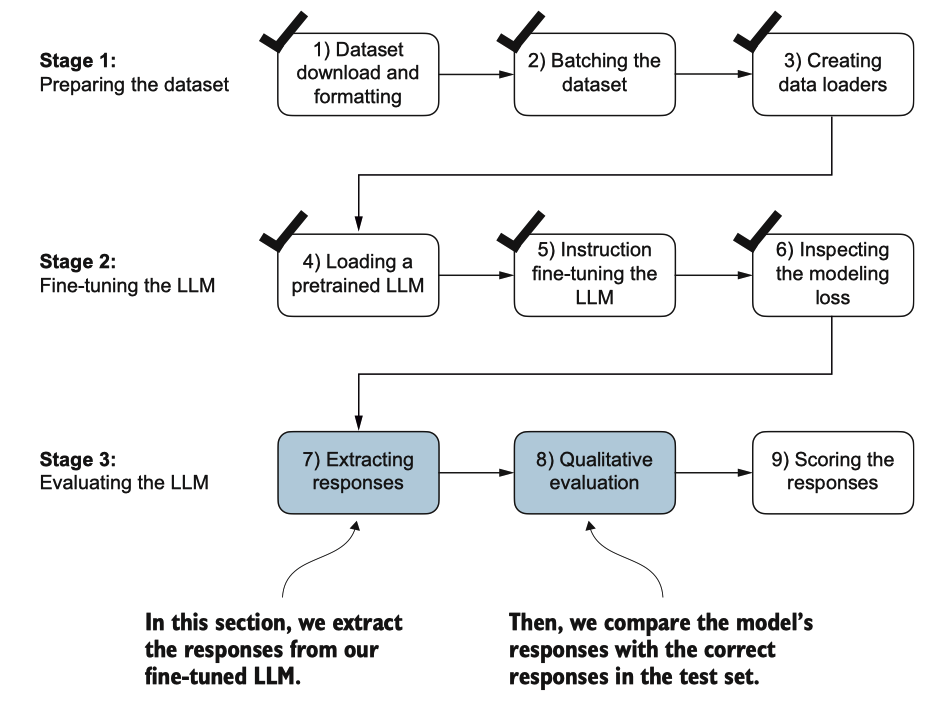
图7.18 LLM的指导微调的三阶段过程。在第三阶段的前两步中,我们提取并收集在保留的 测试数据集上的模型响应以进行进一步分析,然后评估模型以量化指导微调后的LLM的性 能。
为了完成响应指令步骤,我们使用generate函数。然后,我们打印模型响应,以及前三个测试集条目的预期答案,将它们并排展示以便比较:
根据测试集说明、给定的回答和模型的回答,我们可以看到该模型的表现相对较好。 第一和最后一条指令的答案显然是正确的,而第二个答案虽然接近但并不完全准确。
最重要的是,模型评估并不像完成微调那样简单,我们只需计算正确的垃圾邮件/ 非垃圾邮件类别标签的百分比来获得分类的准确性。实际上,像聊天机器人这样的指 令微调大型语言模型(LLM)的评估通过多种方法进行:
- 短答案和多项选择基准,例如《测量大规模多任务语言理解》(MMLU;https://arxiv.org/abs/2009.03300),用于测试模型的通用知识。
- 与其他大型语言模型(LLMs)的人工偏好比较,例如 LMSYS 聊天机器人竞技场(https://arena.lmsys.org)。
- 自动化对话基准,其中使用其他大型语言模型如 GPT-4 来评估回复,例如 AlpacaEval(https://tatsu-lab.github.io/alpaca_eval/)。
在实际操作中,考虑所有三种评估方法是有用的:选择题回答、人类评估和测量对话 性能的自动化指标。然而,由于我们主要关注评估对话性能,而不仅仅是回答选择题 的能力,人类评估和自动化指标可能更为相关。
[!NOTE] Conversational performance
LLM的对话表现(Conversational performance)指的是它们通过理解上下文、细微差别和意图与人类进行类人交流的能力。它包括提供相关和连贯的回复、保持一致性以及适应不同主题和交互风格等技能。
人工评估虽然提供了宝贵的见解,但在处理大量回应时可能相对繁琐且耗时。例如, 阅读并给所有1,100个回应评分将需要相当大的努力。
因此,考虑到手头任务的规模,我们将实施一种类似于自动对话基准的方法,该方法涉及使用另一个LLM自动评估响应。此方法将使我们能够有效地评估生成响应的质量,而无需大量人力介入,从而节省时间和资源,同时仍能获得有意义的绩效指标。
让我们采用一种受到AlpacaEval启发的方法,使用另一个LLM来评估我们微调模型的响应。然而,我们不依赖于公开可用的基准数据集,而是使用我们自己的自定义测试集。这种自定义使我们能够在预期用例的上下文中,更加针对性和相关性地评估模型的性能,这些用例在我们的指令数据集中得以体现。
为了准备本次评估过程的响应,我们将生成的模型响应附加到 test_set 字典中,并 将更新后的数据保存为 "instruction-data-with-response.json" 文件以便记录。 此外,通过保存此文件,我们可以在后续的 Python 会话中方便地加载和分析响应,如有需要。
以下代码清单以与之前相同的方式使用 generate 方法;然而,我们现在迭代整个 tes tset。此外,我们不再打印模型响应,而是将其添加到 testset 字典中。
让我们通过检查测试集(test_set)字典中的一个条目来验证响应是否已正确添加.
最后,我们将模型保存为 gpt2-medium355M-sft.pth 文件,以便在未来的项目中重用。